


AI + optische netwerken: het bouwen van een niet -blokkerende ruggengraat voor grootschalige modeltraining
Jul 23, 2025
Terwijl AI -modellen in honderden miljarden parameters zwellen, moeten de datapijpleidingen die ze voeden gelijke tred houden. Training op schaal over duizenden GPU's vereist meer dan Raw Compute - Het vereist een ultra -high -bandbreedte, niet -blokkerende netwerkstof. In dit bericht zullen we duiken in hoe eenWeergekleed architectuuraangedreven door400 g/800 g optische linkslevert de lage latentie, hoge capaciteit backbone die moderne AI -clusters nodig hebben, en waarom aandacht voorQos, schok, EntopologieontwerpMaakt het verschil in parallelle trainingsprestaties.
1. Waarom traditionele netwerken afbreken op AI -schaal
Conventionele drieledige of overboorde netwerken zijn ontworpen voor verkeerspatronen voor client -server, waar incidentele uitbarstingen van gegevens aanvaardbaar zijn. AI -training genereert daarentegen massaal "Oost -West" -verkeer: gradiënten, activeringen en controlepunten moeten vrijwel constant worden gedeeld met GPU's. Zelfs een kleine microseconde -vertraging of oversubscription kan synchronisatie van de synchronisatie tot stand brengen, waardoor banen op het gebied van meerdere dagen in weken worden uitgerekt.
Belangrijke pijnpunten zijn onder meer:
Bandbreedte knelpuntenWanneer meerdere GPU -pods concurreren om dezelfde uplink
Kop van de kop van de lijnWanneer een overbelaste blad -tot -spine -link andere stromen vertraagt
Jitter en pakketverliesHet verstoren van de synchronisatiepakketten die gedistribueerde training in Lockstep blijven
Om deze te overwinnen, nemen AI -clusters eenniet -blokkerende bladspineOntwerp, waarbij elke bladschakelaar verbinding maakt met elke wervelkolomschakelaar met volledige lijnsnelheid - Idealiter met nul oversubscription.
2. Architectuur van de wervelkolom 101
Een bladspine -stof bestaat uit twee lagen:
Bladlaag: Switches van bovenkant van racks maken rechtstreeks verbinding met servers (GPU -knooppunten).
Wervelkol: Core -wervelkolom schakelt alle bladschakelaars met elkaar verbonden in een volledig gaas.
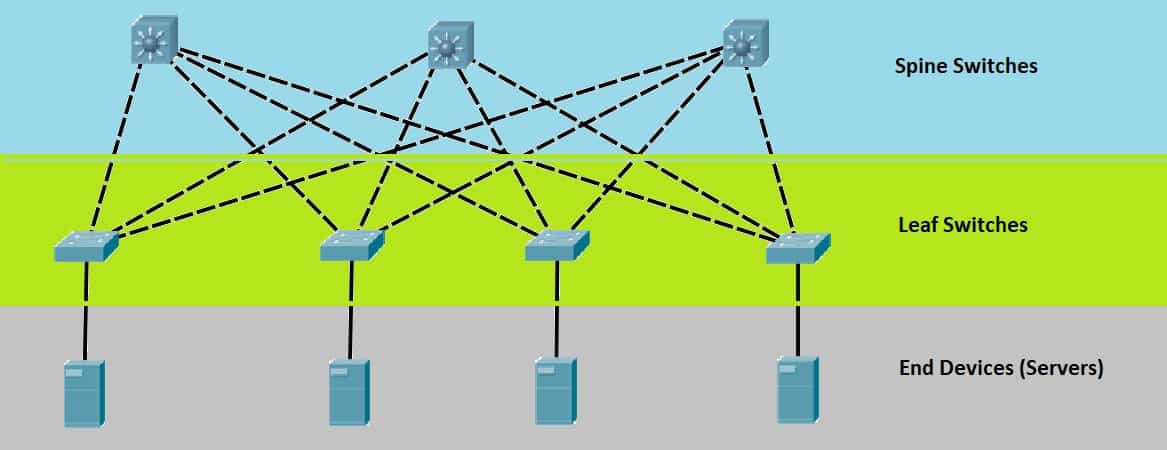
Elke Leaf -uplink voldoet aan elke wervelkolom downlink op volle snelheid, waardoor een gaas ontstaat zonder oversubscription.
In een echt niet -blokkerend ontwerp:
- Als elk blad heeftN400 g poorten naarMStekels, de totale uplinkbandbreedte is gelijk aan de totale downlink bandbreedte.
- Verkeer van elke server kan elke wervelkolom zonder bewering doorkruisen.
- Uitschalen voegt meer stekels en bladeren in slotstap toe.
Deze architectuur zorgt ervoor dat alle parallelle trainingsverkeer -, hetzij tussen GPU's in hetzelfde rek of over rekken - stroomt ongehinderd.
3. 400 g vs . 800 G optische links: afwegingen en use cases
Hoge snelheid optica zijn de snelwegen van uw AI -stof. De twee meest voorkomende rijstrookconfiguraties van vandaag zijn:
| Snelheid | Form -factor | Lanes × Rate | Typisch bereik | Kracht en koeling |
|---|---|---|---|---|
| 400G | QSFP - DD | 8×50G | MMF: tot 100 m SMF: tot 10 km |
~ 12 w per module |
| 800G | OSFP / QSFP - DD | 8×100G | MMF: tot 70 m SMF: tot 2 km |
~ 15 W per module |
- 400GVerbindingen worden vaak de voorkeur gegeven aan bladeren -to -spine uplinks waar moduledichtheid en krachtefficiëntie materie.
- 800GLinks glanzen in wervelkolom -to -spine of wervelkolom -to - kernstoffen, waarbij maximale doorvoer per poort zwaarder weegt dan iets hogere vermogensafname.
Door 400 g te mengen in de bladlaag en 800 g in de wervelkolomlaag, balanceren operators dichtheid, kosten en koelbeperkingen, terwijl ze nog steeds eindto -end niet -blokkerende prestaties leveren.
4. QoS en Jitter: AI -pakketten synchroon houden
Zelfs in een niet -blokkerende stof zijn niet alle pakketten gelijk. Gedistribueerde trainingskaders (bijv. NCCL, Horovod) verzenden latentie -gevoelige besturingsberichten naast bulkgradiëntupdates. Om te voorkomen dat grote gegevensstromen tijdkritische pakketten uitstellen:
Prioriteer synchronisatieverkeerQoS -markeringen gebruiken (bijv. IEEE 802.1p).
Implementeer per -stroom pacingop geavanceerde schakelaars om bursty workloads glad te maken.
Controleer en minimaliseer jitter, de variatie in de aankomsttijd van het pakket, die de middelen- en barrièrebewerkingen kan verstoren.
Moderne switches bieden microseconde -niveau -uitgangsplanning en op hardware gebaseerde prioriteitswachtrijen om ervoor te zorgen dat zelfs onder full -line -ratelladen, besturingsberichten zonder vertraging doorslippen.
5. Topologieoptimalisatie voor parallelle training
Naast basisbladspine nemen AI -clusters deze verbeteringen vaak aan:
Dikke overlays:Meerdere wervelkolomlagen of extra wervelkolomknooppunten om de hoptelling voor de drukste stromen te verminderen.
Ai -bewuste routering:Dynamische ECMP (multi -path van gelijke besturingen) hash afgestemd op alles -naar -alles verkeerspatronen in plaats van willekeurige hashing.
Stoffen met gereduceerde hop:Gerelateerde GPU -rekken op hetzelfde blad of wervelkolom plaatsen om de gemiddelde padlengte te verkorten voor synchronisatie.
Deze tweaks krimpen de staartlatentie van collectieve operaties (bijv. All -Reduce), scheren kostbare seconden van elke training iteratie en leveren algehele versnellingen op.
6. Praktische tips voor implementatie
Kabelbeheer:Gebruik MPO/MTP -patchkoorden in trunks met hoge dichtheid om het rek georganiseerd te houden en de invoegverliezen te minimaliseren.
Power Planning:Controleer of de PDU van uw rack de gecombineerde trekking van meerdere 15 W 800G -modules plus Switch ASIC's aankan.
Thermische profilering:Raadpleeg switch leveranciersrichtlijnen-800 g modules kunnen extra luchtstroom of koellichamen in bepaald chassis vereisen.
Toekomstbereiding:Reserveer lege slots voor QSFP112 of OSFP224 -modules als 1.6T -oplossingen volwassen.
Conclusie
Een niet -blokkerende wervelkolomstof gebouwd op 400 g en 800 g optische schakels is het fundament van de hedendaagse grootschalige AI -trainingsclusters. Door de juiste topologie, optica met hoge snelheid en slimme QoS/Jitter -besturingselementen te combineren, kunt u de consistente, lage -latentie -doorvoer leveren die enorme gedistribueerde modellen eisen.
Klaar om de ultieme AI -stof te architecteren?Verken de optica en de ontwerpdiensten van de wervelkolom van de wervelkolom vanWolonOm uw volgende trainingscluster van stroom te voorzien.


